deepseek-v4-pro-qwen3.5-9b-uncensored-heretic 技术解析:DeepSeek 到底贡献了什么?
deepseek-v4-pro-qwen3.5-9b-uncensored-heretic 把教师、底座和修改工具写进了同一个名字:DeepSeek 是作者所称的教师数据源与命名来源,Qwen3.5-9B 提供模型本体,Heretic 再修改蒸馏后的 Qwen 权重。它是社区衍生模型,不是两家官方联名产品,也不是把 DeepSeek 与 Qwen 权重合并起来的新架构。
本文整合模型关系调研与原稿中的能力、评测和兼容性观察,只做技术解析。【已证实】表示能由公开文件或源码核验;【作者声明】表示模型卡或维护者的单方说明,不等于独立复现。 核查日期为 2026 年 11 月 10 日。
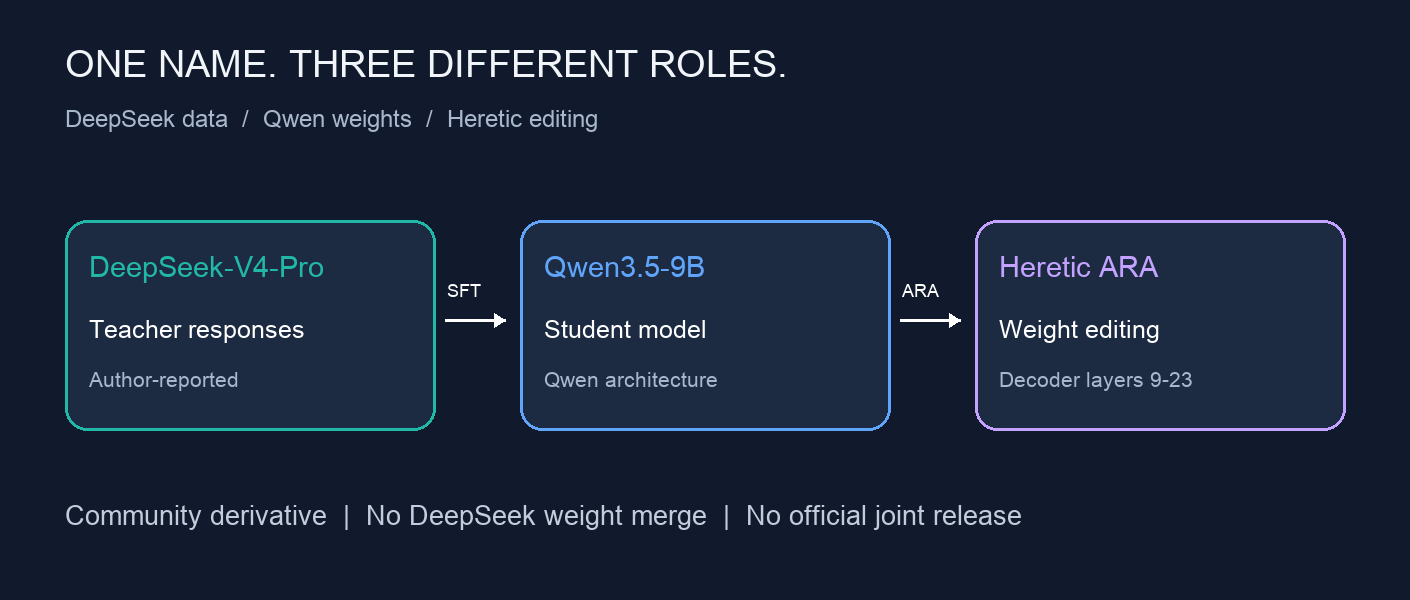
deepseek-v4-pro-qwen3.5-9b-uncensored-heretic 的三层关系
先看来源链,再读名字里的宣传词。
| 环节 | 实际角色 | 证据边界 | | --- | --- | --- | | DeepSeek-V4-Pro | 教师回答与命名来源 | 【作者声明】约 25 万条数学、STEM 样本 | | Qwen3.5-9B → Jackrong 蒸馏版 | 学生架构与权重来源,接受后训练 | 【已证实】配置与权重索引属于 Qwen 架构 | | xtools-at heretic 版 | 对蒸馏后的 Qwen 权重做 ARA 编辑 | 【已证实】模型卡列出工具版本和层范围;效果数字仍属作者自报 |
【作者声明】Jackrong 称先用 DeepSeek-V4-Pro 生成的回答做监督微调(SFT),再进行轻量 GSPO 强化学习;两阶段都没有加入代码数据。这里描述的是响应或数据蒸馏:学生学习教师生成的文本。它不是把教师参数复制进学生,也没有公开证据表明做了逐 token 的 logit 蒸馏。蒸馏版 HF 模型卡
教师身份、样本数量及训练顺序都应保留归因。作者没有随模型公布足以独立复核教师来源的数据集、生成日志和完整训练记录,不能从最终权重反推出“这些回答一定来自 DeepSeek”。卡片里的“Max Effect”也只是作者用语,本文不将它写成经过官方核实的模式名称。
DeepSeek 官方未参与这次社区发布。 公开归属链指向 Qwen、unsloth、Jackrong 与 xtools-at;作者对教师模型的致谢不构成官方合作或背书。目前未发现官方参与的公开证据,不能把“使用教师输出”写成“官方提供训练数据”。Jackrong 模型卡、heretic 模型卡
为什么底座仍是 Qwen3.5-9B
【已证实】Qwen 官方、Jackrong 与 heretic 的公开配置均指向 Qwen3_5ForConditionalGeneration:语言部分 hidden size 为 4096、32 层、词表大小为 248,320。DeepSeek-V4-Pro 的配置则是 DeepseekV4ForCausalLM,对应 7168、61 层和 129,280。
| 配置项 | Qwen / 蒸馏版 / heretic | DeepSeek-V4-Pro | | --- | --- | --- | | 模型架构 | Qwen3_5ForConditionalGeneration | DeepseekV4ForCausalLM | | hidden size | 4096 | 7168 | | 语言层数 | 32 | 61 | | 词表大小 | 248,320 | 129,280 |
来源:Qwen 配置、蒸馏版配置、heretic 配置、DeepSeek 配置。
蒸馏版与当前 heretic 版的索引各含 775 个张量键,并保留 Qwen 的语言模块、视觉模块与 MTP 命名。结合来源声明与配置,这支持“Qwen 后训练衍生模型”的判断,没有 DeepSeek 权重被合并进来的证据。两者结构也不支持常规逐张量加权合并。索引本身只能证明结构,不能证明每个权重的完整训练历史。 蒸馏版权重索引、heretic 权重索引
Heretic 用 ARA 改了什么
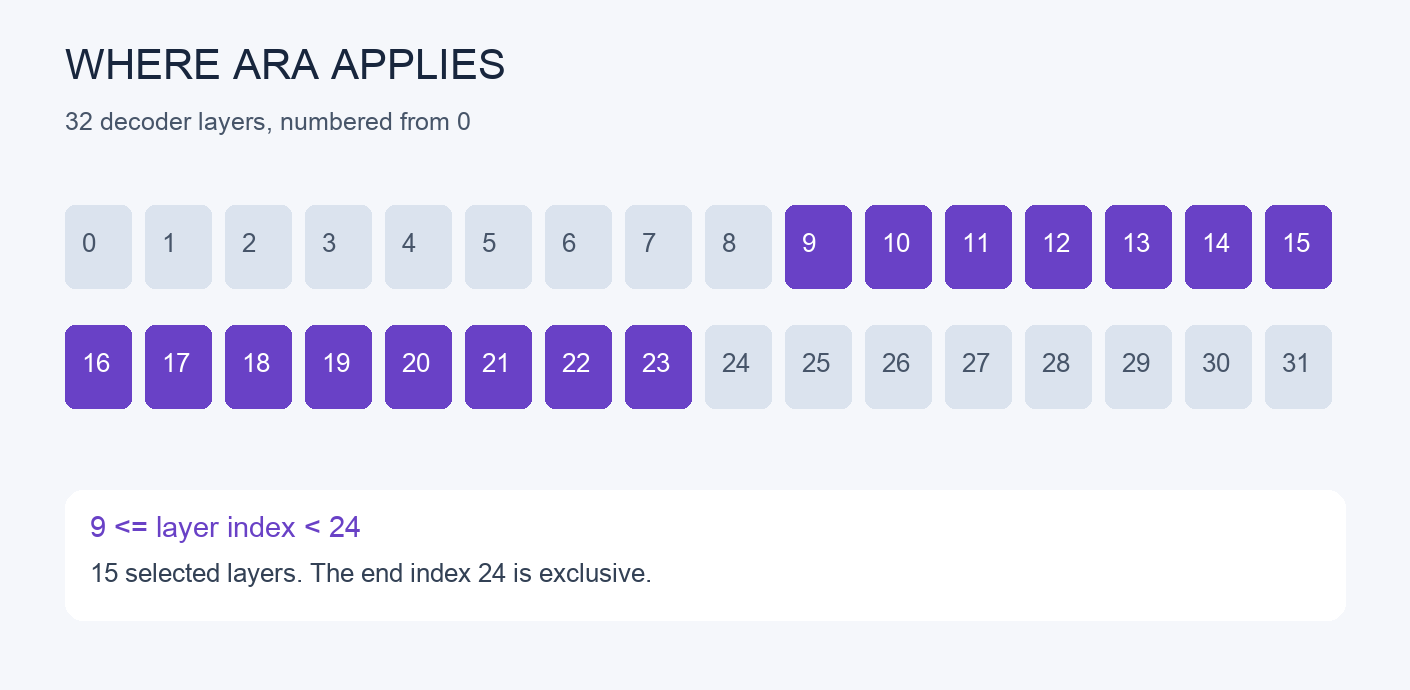
【已证实】heretic 模型卡记录使用 Heretic v2.0.0.dev0,方法为 Arbitrary-Rank Ablation(ARA)。它列出的起始索引是 9,结束索引是 24;结束值不包含在范围内,因此是从 0 编号的语言解码器第 9–23 层,共 15 层,不是第 9–24 层。HF 参数表
ARA 不能简单解释为“找出一个拒答方向,再把它减掉”。Heretic 作者说明,ARA 直接优化选定模块的矩阵修改,在保留一组提示的原有输出与改变另一组提示的输出之间寻求平衡。这里说明的是方法原理,不提供复现去安全限制的参数教程。ARA 原始说明
这一步编辑的仍是已经蒸馏过的 Qwen 权重。DeepSeek 只通过前一阶段作者所称的训练数据间接影响学生;ARA 本身不意味着引入 DeepSeek 权重、架构或分词器。
“3/100 拒答”和高分分别证明了什么
【作者声明】heretic 维护者报告拒答次数从原模型的 100/100 降至 3/100,KL divergence 为 0.0422。这是该测试口径下的结果,不是所有请求只有 3% 拒答的统计保证,也不是第三方安全评测。KL 较小同样不能证明所有能力都被保留。heretic 性能表
原稿提到的 GSM8K 94.50% 和 MMLU-Pro 90.53%,来自 Jackrong 蒸馏版作者自测。前者注明 NVFP4、vLLM、四次平均;后者只是数学、物理、化学三个子集各 500 题的均分,不是完整 MMLU-Pro。不能把这些数值直接写成 heretic 版独立复测成绩,也不能据此宣布“9B 全面超过 70B”或“学生全面超过教师”。上游评测口径
数学与 STEM 是作者报告的数据重点,因此是值得进一步评估的方向;编程、工具调用、图片理解与创作质量,都不能仅由底座能力或模型名字推导。保留视觉结构不等于视觉表现已经验证;较少拒答也不等于回答更准确。
MTP 插曲:结构完整与能力优秀是两回事
【已证实】HF 讨论区记录过 MTP 张量缺失问题:早期索引只有 760 个键,没有 mtp.*,而母模型有 775 个键,其中 15 个属于 MTP。维护者表示已从母模型补回缺失张量;本次核查的当前索引确实包含这 15 个键。HF 讨论 #1、当前索引
这能确认当前文件结构已经补齐,不能代表所有下游量化文件、转换器和运行后端都已完成兼容性验证。原稿中关于工具链故障的提醒因此值得保留,但无需扩展成下载、部署或排障操作教程。
同样,某个量化文件约 5.6GB,并不等于整个运行环境只需这么多内存;模型文件、缓存、视觉组件与运行时开销是不同项目。本文不据此给出未经实测的硬件承诺,也不沿用随时间变化的下载量、趋势排名或“服务器被下崩”等叙事。
读这类模型名称时,先核对四件事
- 谁提供模型本体? 看
base_model、架构配置、分词器和权重索引,而不是只看名称中的大品牌。 - 谁提供训练信号? 区分公开数据证据与作者对教师来源的声明。
- 哪一版接受了评测? 蒸馏版成绩不能直接移给 heretic 版,子集不能写成完整基准。
- 修改达成了什么? 拒答减少、能力保留、安全性与工具链兼容性,需要分别验证。
对 deepseek-v4-pro-qwen3.5-9b-uncensored-heretic,准确的定位是:以 Qwen3.5-9B 为本体、按作者声明使用 DeepSeek 教师回答做响应蒸馏,再由社区作者通过 ARA 编辑第 9–23 层的实验性衍生模型。 DeepSeek 的角色限于教师数据和命名来源,没有官方参与,也没有 DeepSeek 与 Qwen 权重合并。是否适合某个任务,仍需对应版本的独立评测来回答。